¿Cómo desindexar URL de Google después de un hackeo?
Si ha sido hackeado recientemente, habrá notado muchas URL de más en Google, creadas para llenar de spam de forma masiva el índice del motor de búsqueda.
Si ha sido hackeado recientemente, habrá notado muchas URL de más en Google, creadas para llenar de spam de forma masiva el índice del motor de búsqueda.
Requisito previo: limpiar su WordPress
Claramente no es el objeto de este artículo, pero es importante empezar por limpiar el FTP y la base de datos.
Lo ideal es partir de una base de archivos y datos sana anterior al hackeo (de ahí la importancia de hacer copias de seguridad) y asegurarse de corregir la vulnerabilidad que permitió entrar al pirata. Aproveche para cambiar las contraseñas (como mínimo, las de los usuarios del back office y de MySQL).
La idea aquí es evitar que el incidente pueda reproducirse unos días más tarde.
Identificar el formato del "patrón" de las URL pirateadas
El punto común de muchos sistemas de spam automático es generar URL que se parecen todas más o menos. Con esto queremos decir que el contenido del slug responde a una regla que se puede reproducir con una expresión regular. Ya veo a los del fondo empezando a sudar: sí, vamos a escribir regex, pero nos mantendremos en lo sencillo.
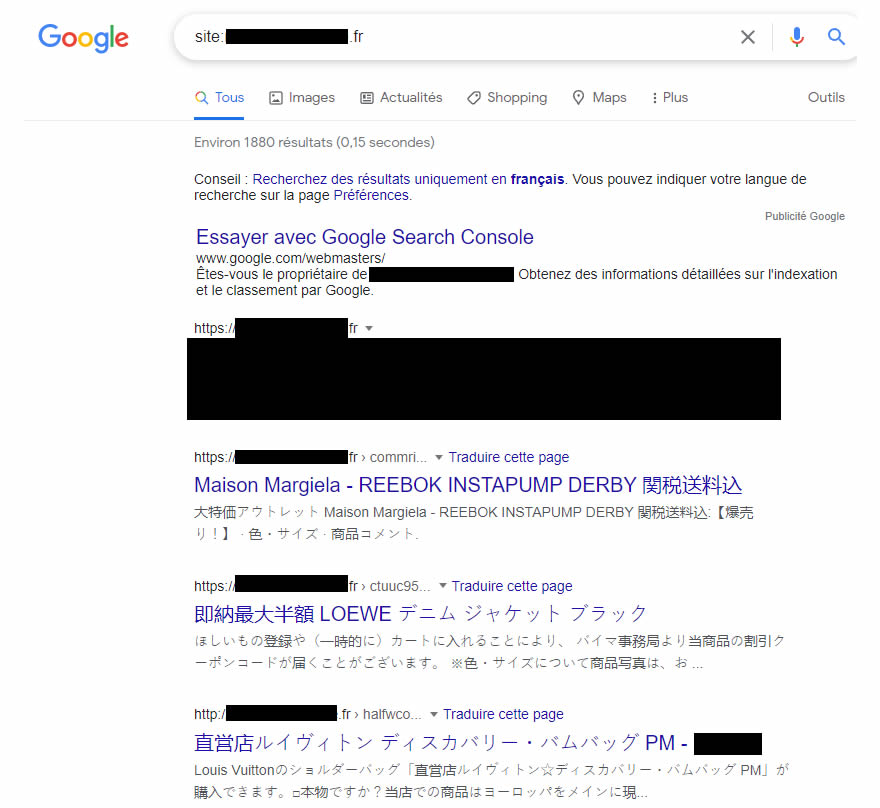
Para encontrar este patrón, empecemos haciendo un site: en Google. Como recordatorio, el comando site:nombre-de-dominio devuelve todas las URL del sitio que están indexadas. Ejemplo: site:swan.tools

lista de URL pirateadas en Google con el comando site:
En el ejemplo de este sitio, encontramos por ejemplo estas URL:
- https://nom-de-domaine.fr/conmrixzp741732
- https://nom-de-domaine.fr/ctuuc961439
- http://nom-de-domaine.fr/haxfwcowv6881
- http://nom-de-domaine.fr/chlwfzkle658271
- http://nom-de-domaine.fr/fjsxt794539
- http://nom-de-domaine.fr/ngogtvudqw9573192
Por supuesto, la lista no es exhaustiva y he cambiado voluntariamente algunas letras para que no identifique con demasiada facilidad al desafortunado propietario que tuvo la amabilidad de prestarme su caso para este tutorial.
Observamos aquí que la URL (slug) de cada página pirateada empieza por una serie de letras seguida de una serie de cifras. Eso es un patrón (así de simple).
A partir de ahí, intentaremos identificar las variaciones encontrando una regla que no cubra las URL legítimas de nuestro sitio web, pero aquí no debería haber ningún problema.
En nuestro caso, identificamos que la URL empieza por 5 a 10 letras seguidas de una serie de 4 a 7 cifras según las URL.
Nuestra expresión regular será, por tanto, esta:
^[a-z]{5,10}\d{4,7}$
Tenga en cuenta que puede ampliar los rangos de cantidad de caracteres siempre que no exista riesgo de que coincidan con una URL legítima de su sitio.
Preparar la regla de redirección para Apache
Vamos a preparar aquí una regla que tendrá dos efectos:
- Indicar a Google que la página ha desaparecido
- Pedir a Google que no conserve esta página en su índice
RewriteRule ^[a-z]{5,10}\d{4,7}$ - [E=NOINDEXNOFOLLOW,G]

Header always set X-Robots-Tag "noindex, nofollow" env=NOINDEXNOFOLLOW
Si estas líneas no funcionan (como por ejemplo en el cPanel de un conocido proveedor de alojamiento francés), es que hay que añadir la definición del documento 410 al principio del archivo, lo que da esto:
<IfModule mod_rewrite.c>

        RewriteEngine On

	RewriteBase /

	ErrorDocument 410 default

	RewriteRule ^[a-z]{5,10}\d{4,7}$ - [E=NOINDEXNOFOLLOW,G,END]

	Header always set X-Robots-Tag "noindex, nofollow" env=NOINDEXNOFOLLOW

</IfModule>
En la primera línea encontramos nuestra regex para identificar las URL afectadas; luego, como puede ver, no indicamos una URL de redirección sino un simple "-", que, combinado con la letra G en la parte de flags a la derecha, permite decir que la URL es Gone. Es el famoso código 410, que indica que la URL no volverá nunca y no está redirigida. El flag E= sirve aquí para definir una variable de entorno que llamamos (la etiqueta es arbitraria) NOINDEXNOFOLLOW; podríamos haberla llamado toto y funcionaría igual de bien.
En la segunda línea indicamos que, aun así, enviamos una cabecera HTTP X-Robots-Tag "noindex, nofollow", que actuará como una meta robots en el head del HTML. Solo que aquí no necesitamos modificar el código fuente del sitio.
Por tanto, lo ideal es colocar estas 2 líneas al principio de su archivo .htaccess, justo después de la línea RewriteEngine On.
Si desea ir más lejos, por ejemplo acelerando la toma en cuenta, puede crear un sitemap completo de estas URL o un mapa del sitio HTML siguiendo, por ejemplo, este tutorial sobre cómo acelerar la toma en cuenta de un plan de redirección. Para limitar el riesgo de un nuevo ataque, vea también cómo identificar un sitio seguro y nuestra guía del protocolo HTTPS.